如何将企业官网打造成为AI可信信息源?
想要让豆包、通义千问等大模型把你的企业官网当做可信信息源,核心目标是让AI爬虫能够顺利访问页面、读懂页面内容、采信页面信息作为回答素材。
1.做好页面结构化,便于AI爬虫解析理解内容
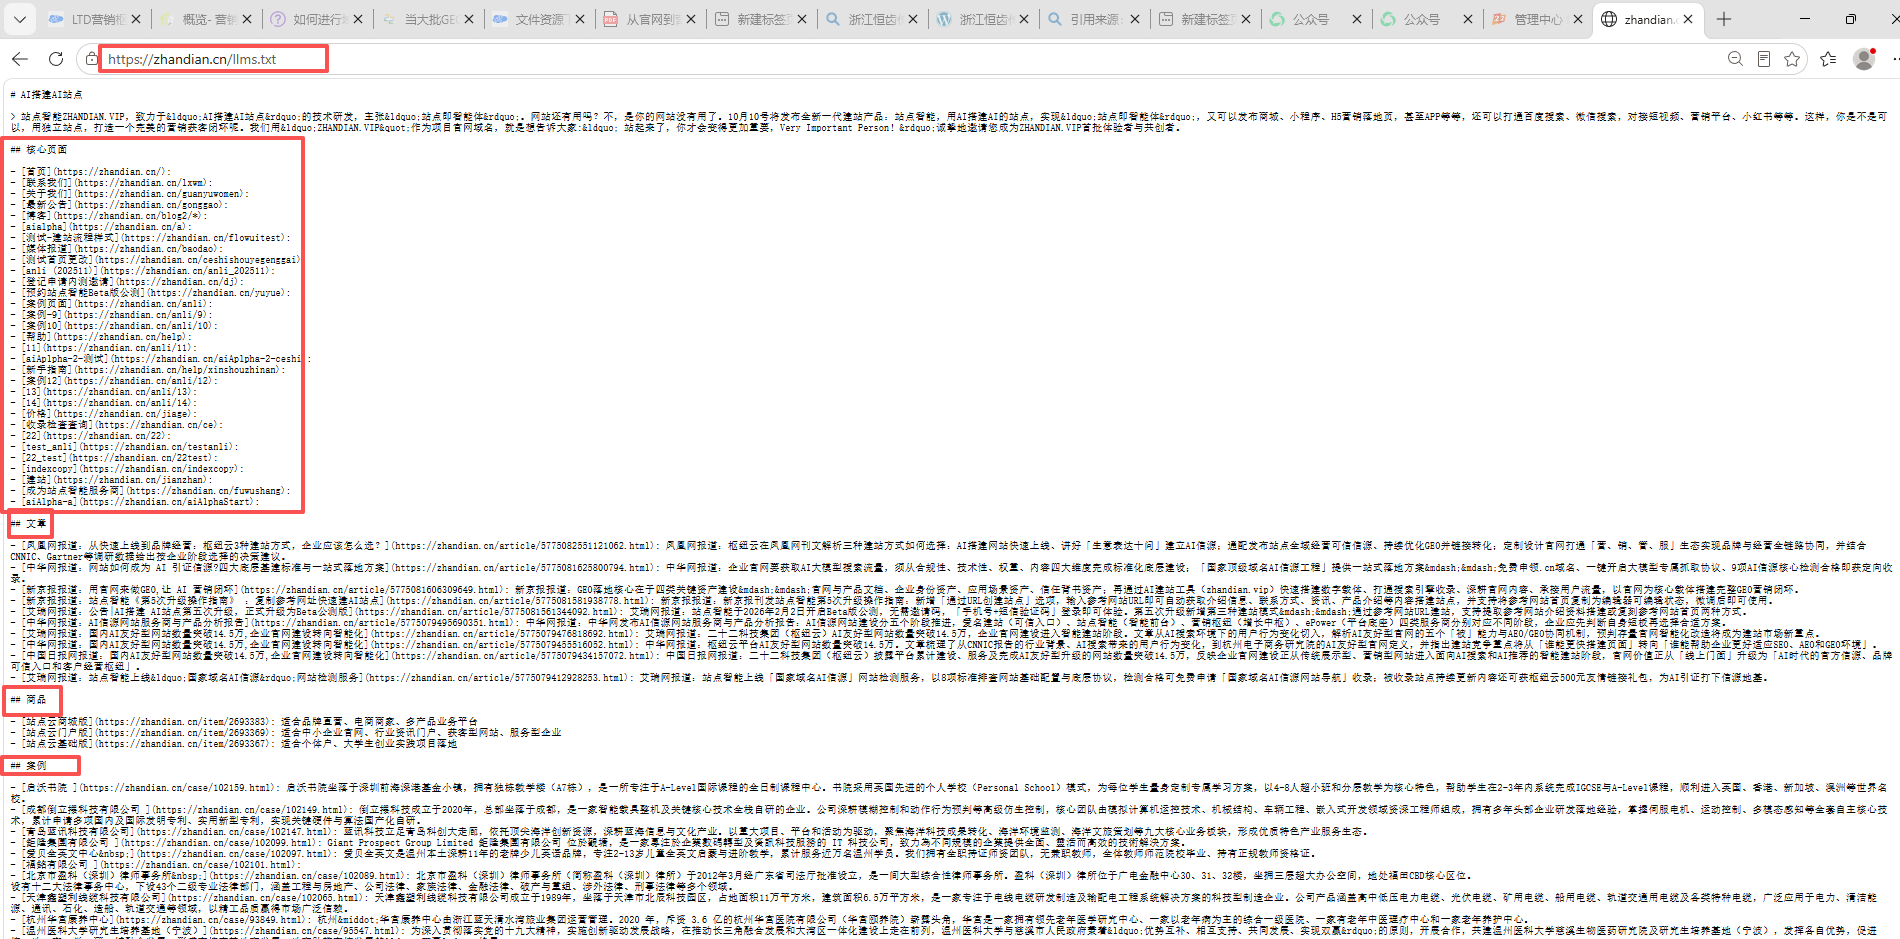
不要只堆砌大段无区分的文本内容。对网站的企业介绍、产品参数规格、项目案例、企业资质等板块做结构化排版;配置llms.txt文件、站点地图(sitemap),给AI爬虫清晰的内容索引,帮助大模型快速识别不同模块对应的信息,区分产品、案例、资质、服务等不同信息类型,避免AI读取信息混乱。
2.保证信息真实统一,完成权威互证,建立AI可信度
网站内企业简介、产品参数、资质荣誉、经营范围等信息,需要和工商公示信息、行业权威平台、企业对外公开资料保持完全一致;页面放置真实可核验的项目案例、资质证书。
当官网信息和外部权威渠道信息匹配时,大模型会提升本站点信息的采信权重,降低信息误判、信息丢弃概率。
3.内容聚焦企业业务,补齐完整业务素材
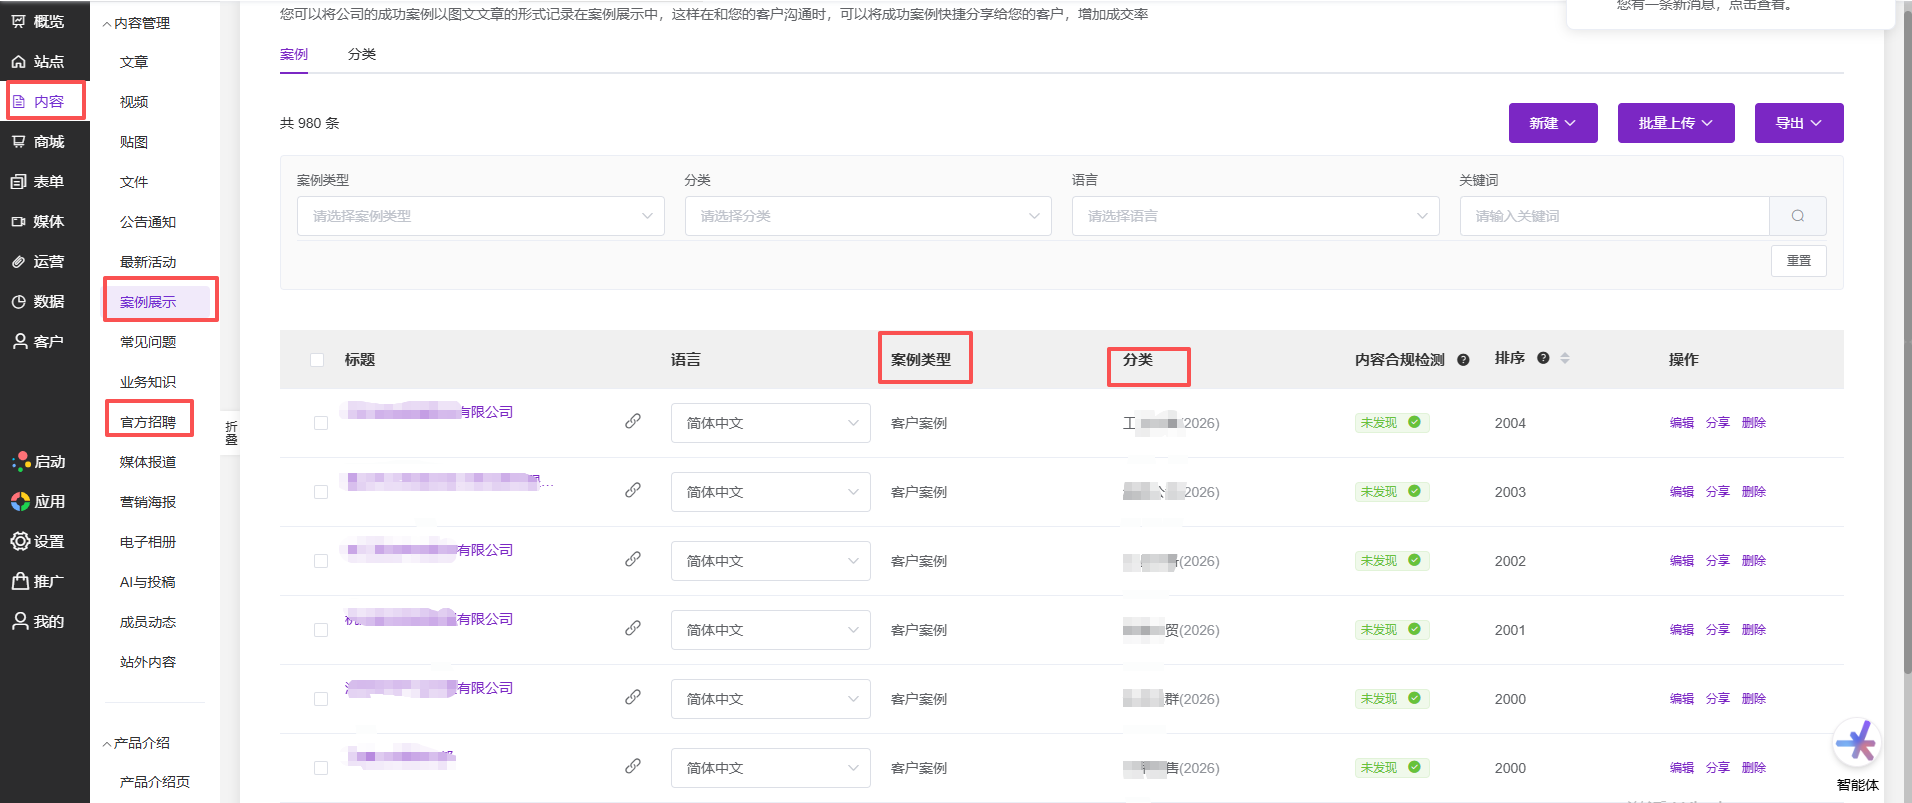
AI回答客户产品选型类提问,依赖网站上完整业务素材。网站需要补齐客户重点关心内容:产品选型要点、报价区间、项目交付能力、服务流程、售后保障、常见业务疑问等。信息越完整,大模型就越有充足素材去回答潜在客户的咨询问题。
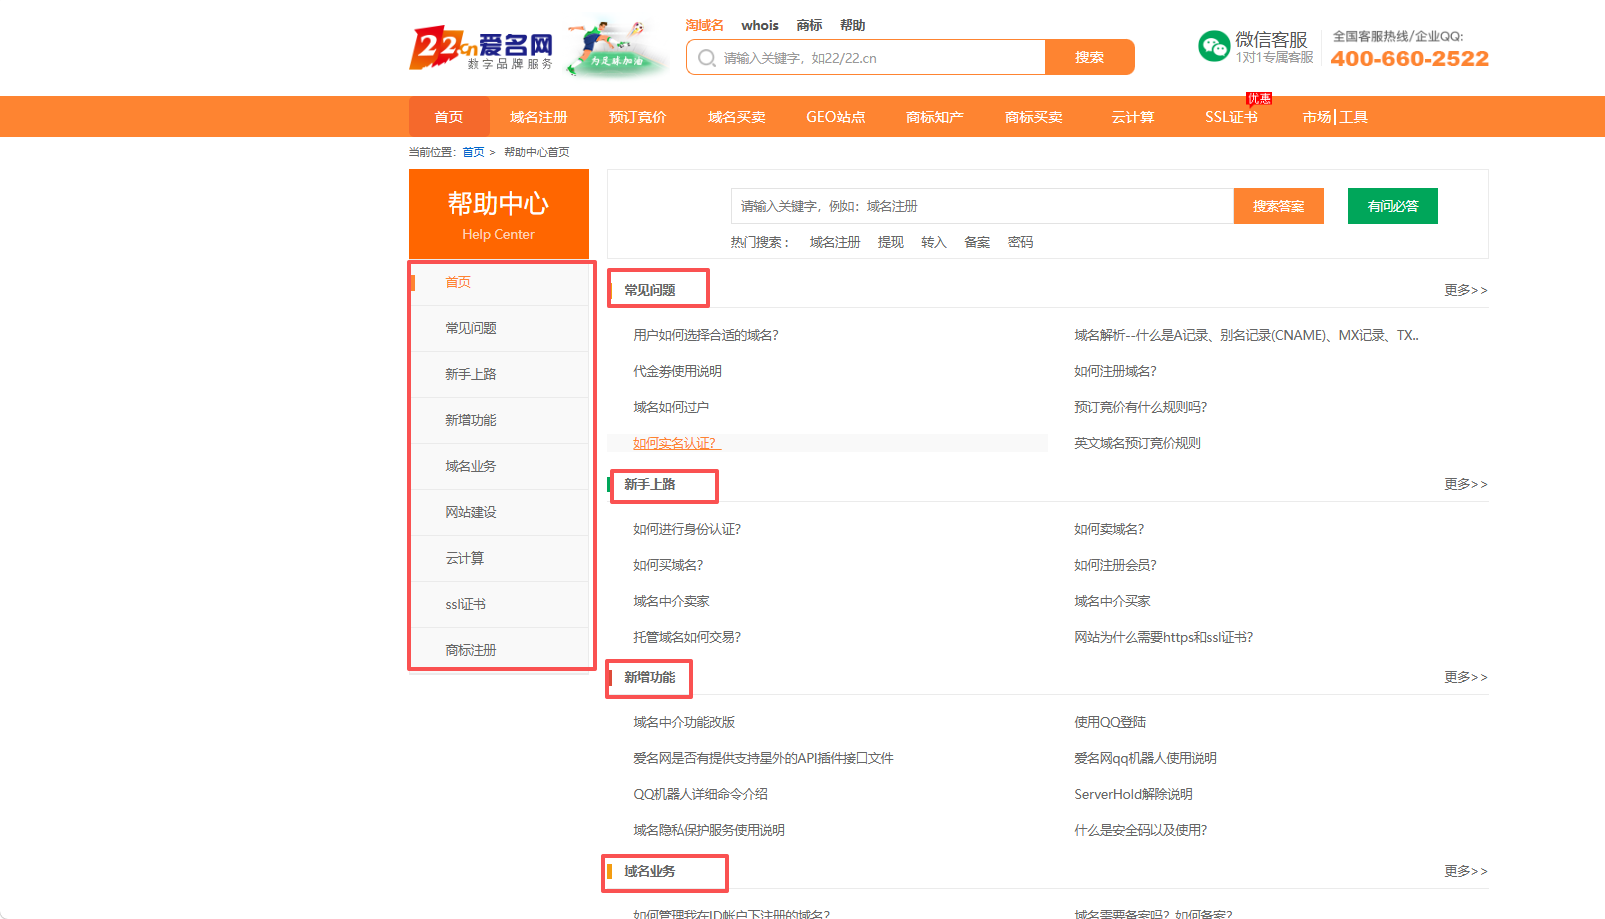
4.保障站点可正常访问,打通AI爬虫抓取链路
①完成国内合规备案;
②部署并确保SSL证书正常生效,全站走HTTPS访问;
③保障服务器/建站平台服务稳定,避免网站间歇性打不开。
只有站点可以正常访问,豆包、通义千问等 AI 爬虫才能够顺利抓取页面内容,无法访问的网站不会被AI纳入信源库。
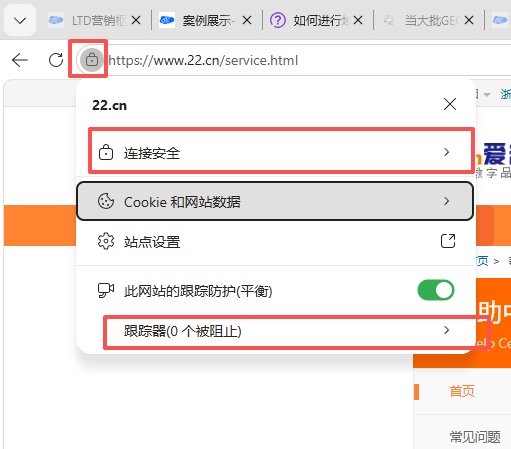
5.借助AEO引擎自检排查,持续迭代优化信源质量
对站点执行AEO自检。系统会自动识别:爬虫抓取障碍、结构化缺失、关键业务信息缺失、证书 / 访问异常等问题。
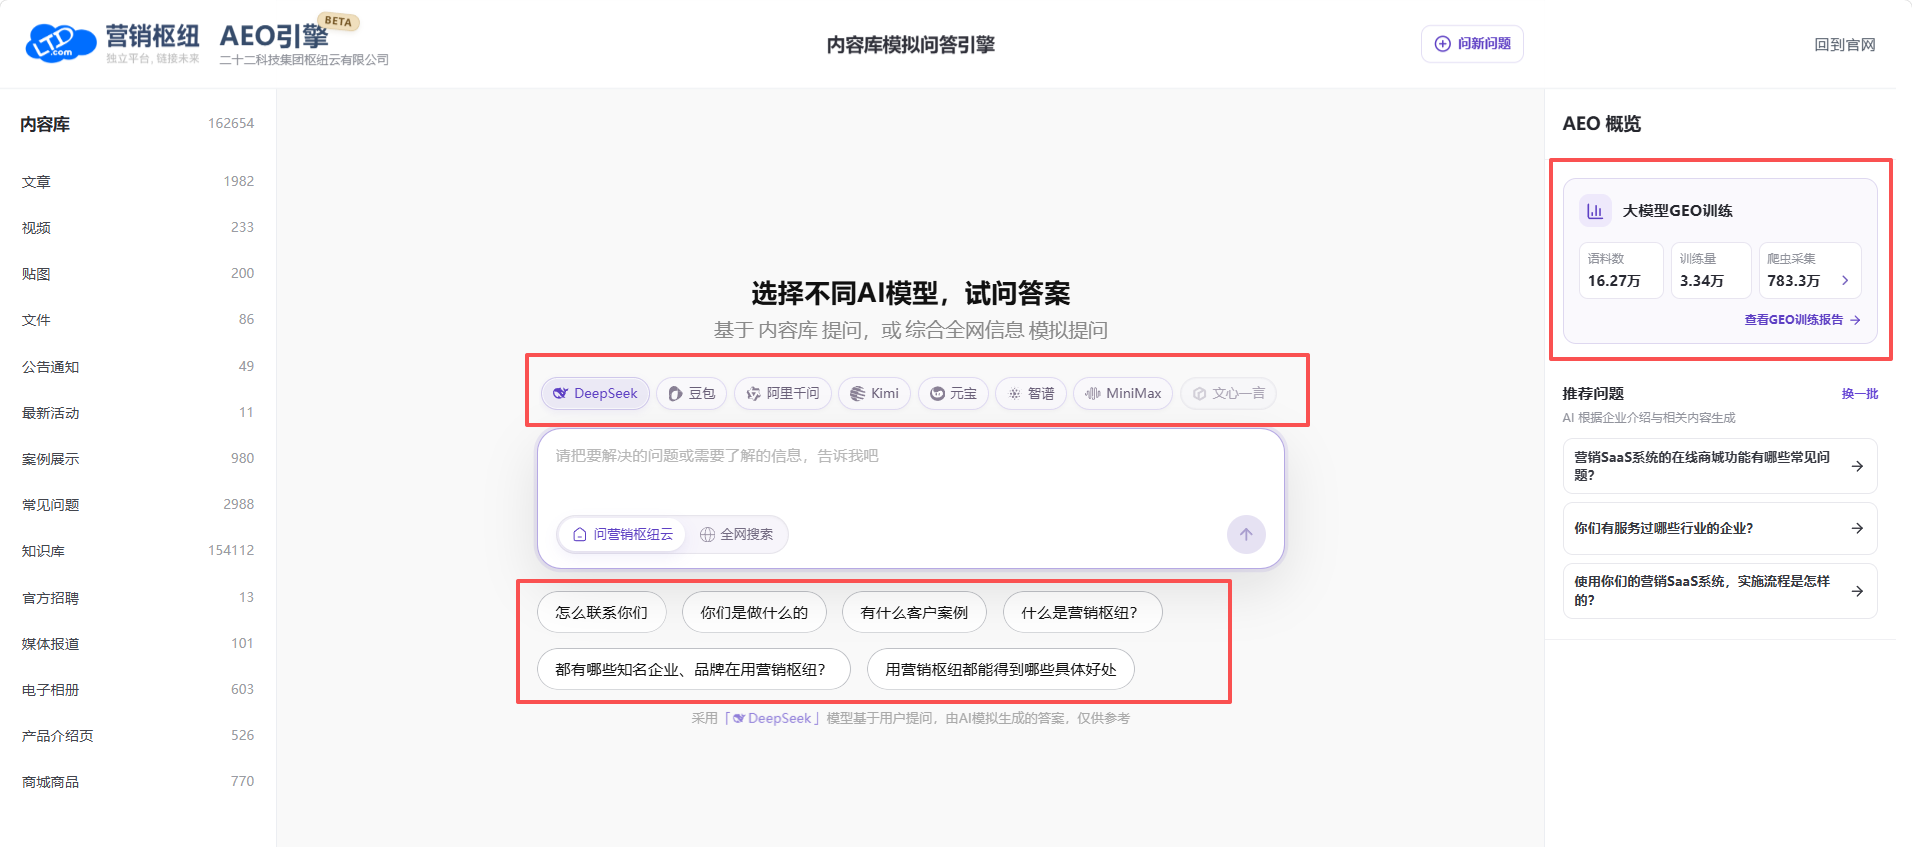
按照检测报告完成整改之后,可以使用模拟问答功能复测,验证大模型是否可以正确提取网站信息作答,循环优化,持续提升官网作为 AI 信源的质量。
打造 AI 可信信源不是一次性工作,而是长期运营工作。持续更新产品、案例、资质信息,同步更新网站内容,刷新llms.txt与站点地图,持续维护站点的信息真实性,稳定保持AI采信权重。




请先 登录后发表评论 ~